WindowsでAIツールの結果を受け取ったら、日本語が文字化けしたり、絵文字のところで処理が止まったりしたことはありませんか。今回は、Pythonで日本語データを受け渡すときの文字コードを、公開してよいダミーだけで実機検証しました。
ClaudeやCodexを使う開発でも、生成された文章を別の処理へ渡す部分は確認が必要です。この記事はAIサービス自体の不具合を検証したものではなく、その周辺にある自動処理の練習です。10月18日に収集した運用候補を、2026年10月19日に試しました。新製品の発表記事ではありません。
先に結論:送り手・受け手・保存先を揃える
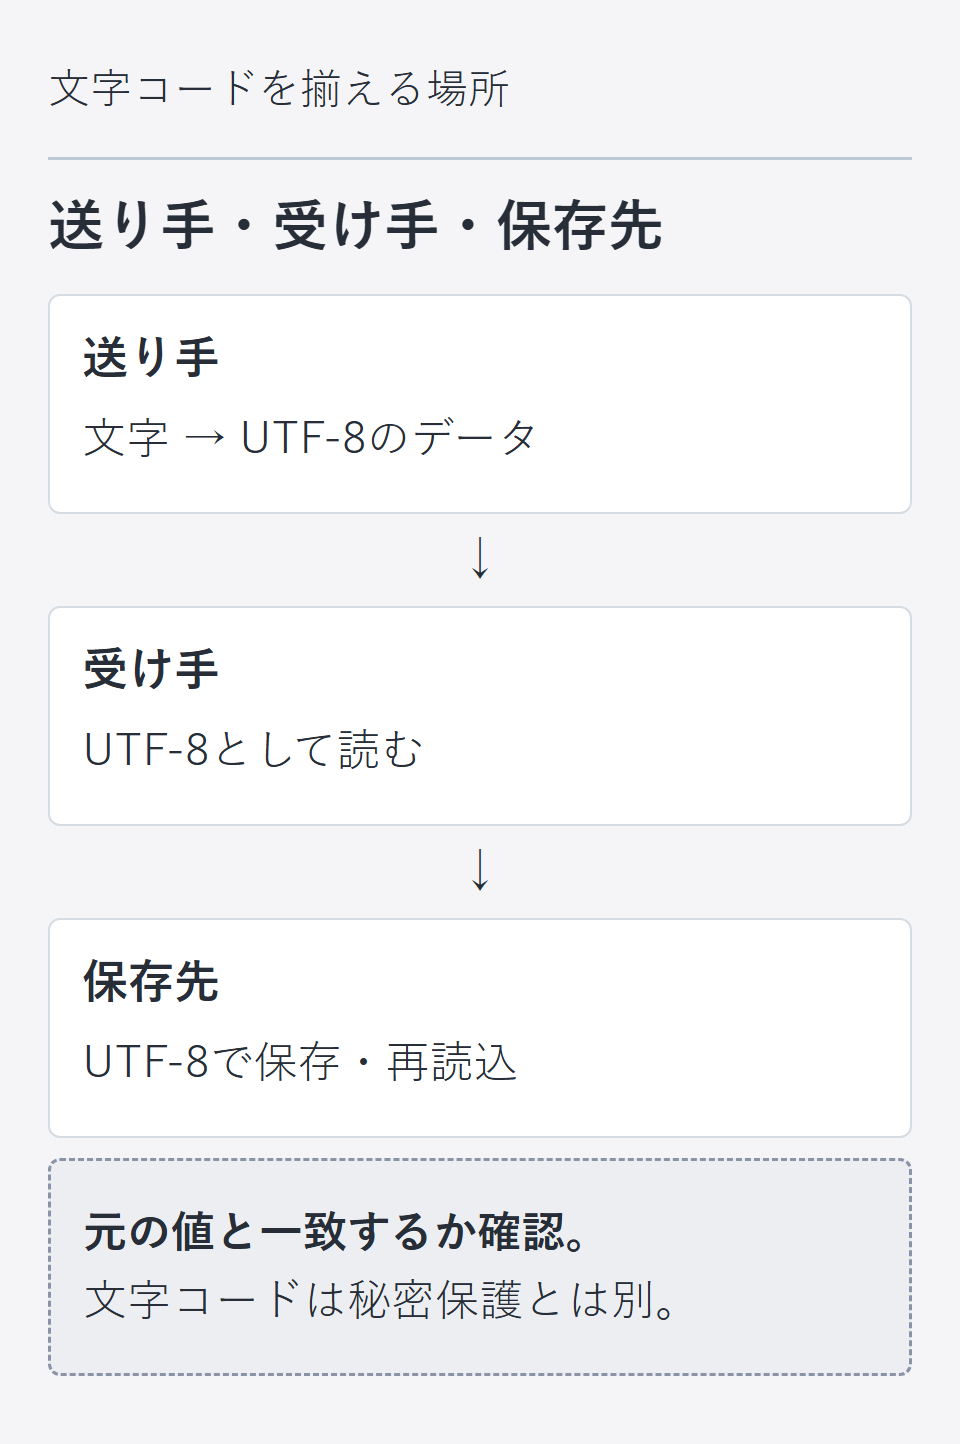
- UTF-8で送ったデータは、受け手もUTF-8として読みます。保存と再読込にも明示します。
- 見た目だけで判断せず、日本語・絵文字・数値を含むダミーが元の値と一致するか確かめます。
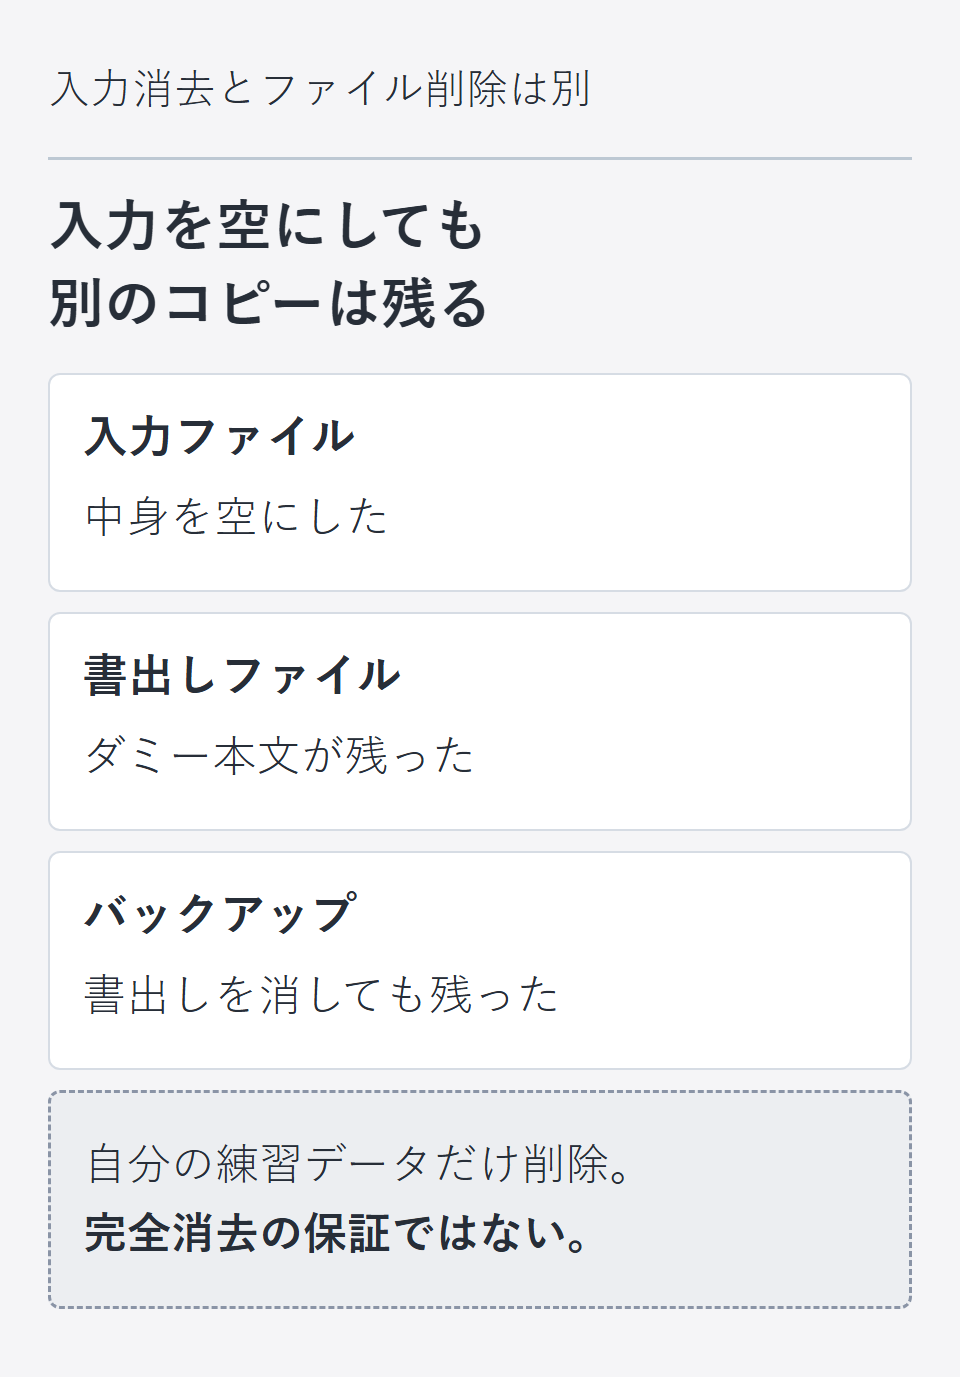
- 入力を空にしても、書出しファイルとバックアップは残ることがあります。
機密情報は使いません。文字コードを揃えることと、情報漏洩を防ぐことは別です。
文字コードは「文字を読む約束」
文字コードは、文字をどの数字の並びで表すかという約束です。同じバイト列でも、受け手が別の約束で読むと、エラーや文字化けにつながります。cp932はWindowsの日本語環境で使われる文字コードのひとつですが、すべての絵文字を表せるわけではありません。
今回の検証はWindows 11、Python 3.12.14、既存の標準ライブラリだけで行いました。追加パッケージの導入、GPU、従量課金APIは使っていません。最新のPythonへの更新を勧める記事ではなく、実測した版を明記しています。
公開ダミーで小さく練習する
まず、自分で作った空の練習フォルダーを用意します。既存のresult.jsonがある場所は避けてください。下のコードをUTF-8でsample_utf8.pyとして保存します。
例の処理はメモリ内の受渡しとファイル保存です。外部通信するコードや機密情報を追加しないでください。後述の安全試験は別の専用検証環境で行っています。
import json
import sys
from pathlib import Path

sys.stdout.reconfigure(encoding="utf-8", errors="strict")
original = {
    "message": "公開ダミー:字幕を確認しました \N{CHERRY BLOSSOM}",
    "count": 3,
    "note": "機密情報は使いません",
}
# 送り手:文字をUTF-8のバイト列へ
wire = json.dumps(original, ensure_ascii=False).encode("utf-8")
# 受け手:同じUTF-8として読む
received = json.loads(wire.decode("utf-8", errors="strict"))
assert received == original
# 保存先と再読込でもUTF-8を指定
path = Path("result.json")
path.write_text(
    json.dumps(received, ensure_ascii=False),
    encoding="utf-8",
)
restored = json.loads(path.read_text(encoding="utf-8"))
assert restored == original
print(json.dumps(restored, ensure_ascii=False))
コピー用のコードでは、花の絵文字を \N{CHERRY BLOSSOM} と書いています。実行時の値は同じ花の絵文字です。
そのフォルダーで次を実行します。Pythonが既に使える環境が前提です。pythonが見つからない場合は、この練習のために無断で環境設定を変更せず、利用中のPythonの実行方法を確認してください。
python -X utf8 sample_utf8.py正常なら、日本語・絵文字・countの値を含むJSONが表示され、result.jsonができます。途中のassertは元の値との一致を確認しています。これは通信を模したバイト列の受渡しで、AIへの送信ではありません。今回、この掲載例も専用検証環境で実行し、保存後の一致を確認しました。
別のPython処理を呼び出す実装では、子側の出力だけでなく、親側のsubprocess.runでもencoding="utf-8"など読み方を合わせる必要があります。片側の設定だけを変えて、相手が出す文字コードを決めつけないようにします。詳しい指定はPython公式のsubprocess説明で確認できます。
実機で確認した結果
| 条件・操作 | 今回の結果 |
|---|---|
| 日本語と絵文字をcp932で出力 | UnicodeEncodeErrorを再現 |
| UTF-8の出力をUTF-8で読む | 元のJSONの値と一致 |
| JSONをASCII表現にして受け渡す | 復号後の値が一致 |
| UTF-8の出力をcp932で読む | 不一致または読取エラーとして検出 |
| errors="replace"で読む | 文字が置き換わり、元の内容と不一致 |
| BOM付きUTF-8のJSON | utf-8-sigで一致。utf-8読取ではJSONエラー |
全体では、独立した検証プロセスの起動から削除までの確認を含め、10確認が期待した結果になりました。意図的なエラーの再現も含む件数で、すべてのコマンドが正常終了したという意味ではありません。今回の小さな入力での結果であり、速度改善や全アプリでの互換性を示す数値ではありません。
通信・保存・削除の注意点
文字コードが揃っても、保存した本文は残ります。入力を消す操作と、別に書き出したファイルを消す操作は分けて考えます。
何をどこへ送ったか
専用の検証では、各プロセスでDNS解決とソケット生成を意図的に試し、Pythonの呼出境界で拒否しました。DNSの試験先は無害なダミー名です。実際にネットワークへ送る前に止めています。自作の試験コードには、解析・認証・HTTP・WebSocket・beacon・worker機能はありません。
検証プロセスは8回起動し、それぞれDNS解決APIとソケット生成の拒否を確認したため、通信の拒否は計16件です。範囲外の自作ダミーの読取も各回で拒否し、計8件でした。開始・対象操作への到達・拒否・結果を同じ試行とプロセスで照合し、別原因のエラーを遮断成功として数えていません。
これはPython内のAPI境界での確認です。OS全体の通信遮断や、悪意あるコードの完全な隔離は保証しません。監査フックの限界はPython公式説明にも記載されています。通信拒否を維持した状態で、実処理と書出しが成立したことを確認しています。
何が端末に残ったか
専用検証では、入力、書出し、バックアップ、BOM付きのファイルへダミー本文が平文で保存されました。別プロセスで再読込しても内容が一致し、入力を空にしても書出しとバックアップは残りました。書出しだけを削除してもバックアップは残りました。終了しただけでは自動で消えません。
検証の最後は、全検証プロセスの終了後に専用作業フォルダーの残存ファイルを削除し、フォルダーが存在しないことを確認しました。一方で、検証コード・原稿・公開ダミーを含む証拠・バックアップは別に保管しています。作業用データの削除を、全コピーの完全消去とは扱っていません。
練習後の片付け
自分で作った練習フォルダーのresult.jsonを開き、ダミーだけであることを確認して削除します。sample_utf8.pyを残す場合は、そこにもダミー本文が書かれています。不要ならこのファイルも削除してください。バックアップや同期先へ複製した場合は、そちらは別に残ります。自分の練習ファイル以外は削除しないでください。
つまずきと、今回確認していないこと
- 文字が化けてもエラーが出ない:errors="replace"はエラー回避のために文字を変えることがあります。JSONとして読めることだけで合格にせず、元の値と比較します。
- UTF-8なのにJSONを読めない:先頭にBOMがあるファイルではutf-8-sigが必要な場合があります。すべてのファイルを無条件に同じ形式へ上書きする対処は避けます。
- 画面では動くが自動処理で失敗:使用するPython、文字コード、作業フォルダーを確認します。今回の準備作業でも文字コードの不一致で保存に失敗し、受渡しを明示してやり直しました。
未確認なのは、ClaudeやCodex本体の内部処理、実案件・機密データ、OS全体や別プロセスの通信、ネイティブ処理、他ユーザーからのアクセス権、サーバー側の保持・削除、ディスクから復元できない完全消去です。標準ライブラリ全体の安全性や既知脆弱性ゼロを認定した検証でもありません。
この練習は既存Pythonの無料のローカル機能だけで行えます。AI APIや有料サービスを追加する場合は、費用と送信内容の確認が別に必要です。電力・保存容量・作業時間の負担はあります。Pythonの利用条件は公式ライセンスを参照してください。
Python本体の後続版には、通信や圧縮ファイル処理などのセキュリティ修正があります。実運用では、環境の管理元の更新方針と公式セキュリティ情報も確認してください。本稿は文字コードの練習に対象を絞っています。
まとめ:小さなダミーで、受け取った中身まで見る
日本語の自動処理は、送り手・受け手・保存先の文字コードを揃え、元の値と一致するか確かめることから始められます。開発の引継ぎにも、使用したPython、文字コード、入力、期待する出力、実際の結果、残るファイルを書いておくと、次の担当者が確認しやすくなります。
まずは公開してよい小さなデータで確認し、既存の本番ジョブや機密ログへ適用する判断は別に行ってください。
よくある質問
JSONをASCII表現にすれば秘密になりますか?
いいえ。ensure_ascii=Trueは文字の表し方を変えるだけで、通常のJSON処理で元に戻ります。暗号化ではありません。
UTF-8指定だけで全部直りますか?
相手の出力形式やBOM、ファイルの実際の文字コードも関係します。今回確認した条件を、全ツールへそのまま当てはめないでください。
文字コードを指定しないとどうなりますか?
Pythonの版、起動方法、設定によって既定値が変わります。保存ではencodingを明示し、読取側も合わせる方が条件を追跡しやすくなります。